「它怎么又忘了」这句话,八成是把三种不同的记忆混成了一种。会话内记忆、跨会话长期记忆、结构化档案,各有各的边界,用错地方就会一直失忆。
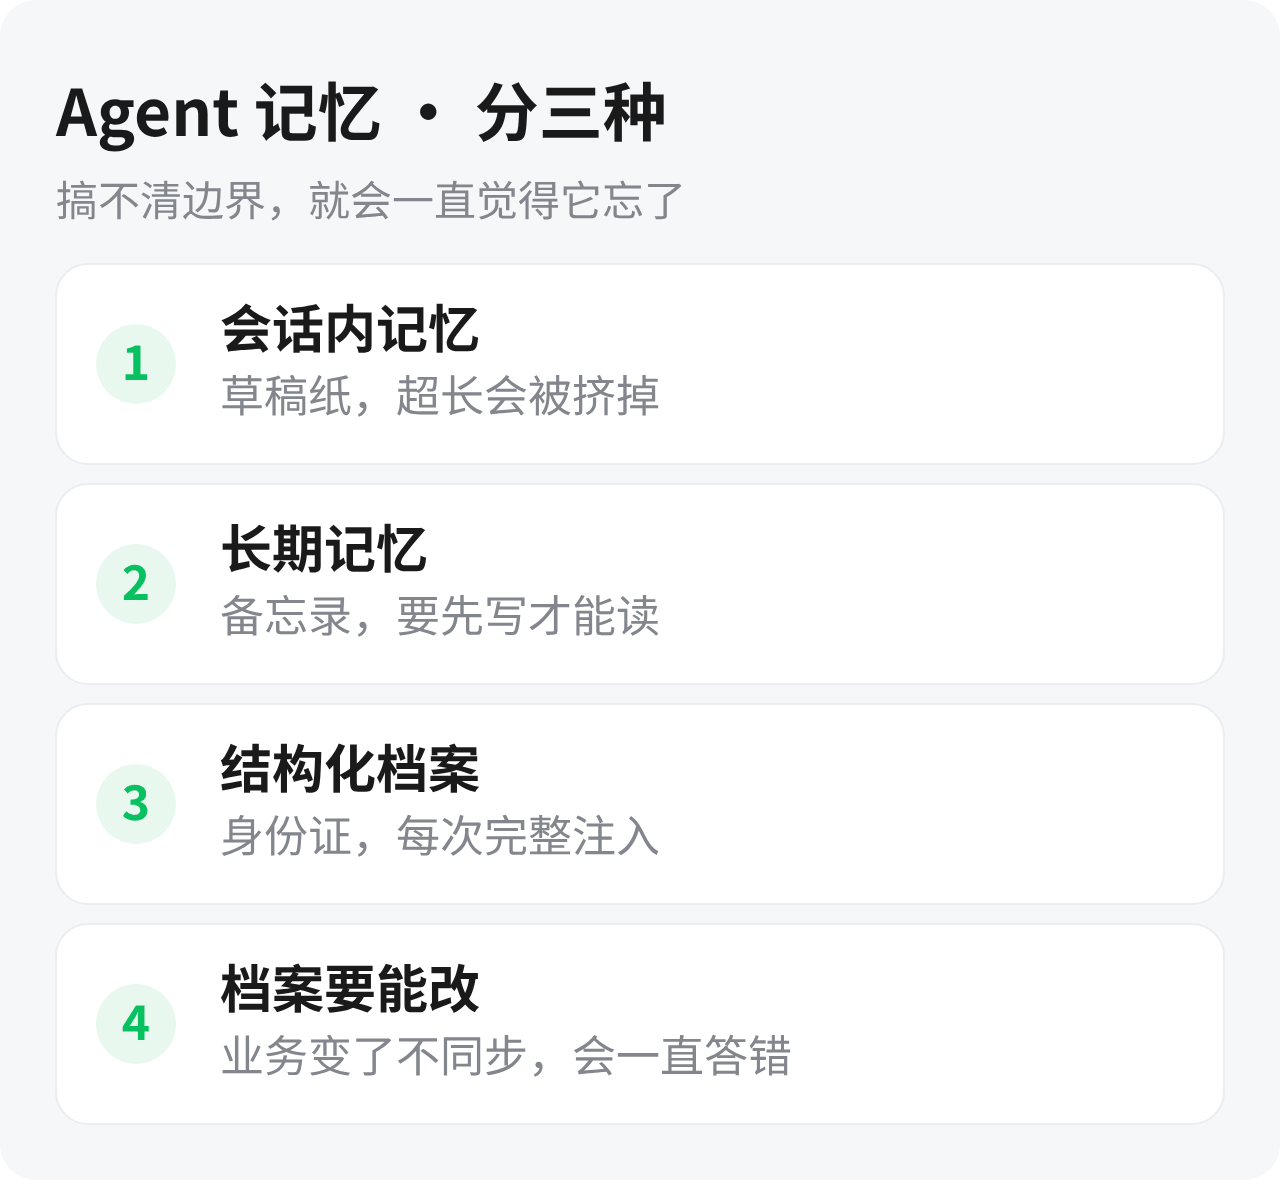
第一种:会话内记忆,只在这一次对话里有效
你在这轮对话里说的内容,模型能看到,因为它们在上下文里。但上下文有长度上限,超过之后最早的内容会被挤掉。表现出来就是:聊到一半,它突然忘了你开头说的要求。
这不是 bug,是物理限制。判断方法很简单——如果你说的话在几十轮之后失效,就是上下文被挤掉了。
应对办法两个:一是在关键节点主动复述一次核心要求(「记住,我们是做女装的,客单价 300 到 800」);二是把长任务拆成几个短会话,每个会话开头重新交代一次背景。
第二种:跨会话长期记忆,需要显式写入
关掉窗口再打开,新会话是白纸——除非系统做了持久化记忆。这一层的关键是「写」这个动作:信息必须先被写进记忆库,下次才能被读出来。没写,就一定记不住。
写入有两种方式:
- 用户主动写。说「记住:我们的主打产品是 XX,目标客户是 XX」,系统把它存成一条长期记忆。
- 系统自动抽取。对话中识别到稳定的事实(公司名、行业、偏好、常用格式),自动写入。这种方式省事,但会漏,也容易记错。
我们的做法是两种并用,但重要信息一定要求显式确认——写完让 Agent 复述一遍「我记住的是这几点,对吗」,确认无误再存。这一步花十秒,能省掉后面无数次纠正。
第三种:结构化档案,最稳的一种
真正靠得住的记忆不是「聊天聊出来的」,是提前写好的档案。把不会变的信息整理成一份结构化文档——公司简介、产品线、客户名单、话术风格、禁用词、常见问答——每次会话开始时注入。
为什么这种方式最稳?因为它是确定性的:不依赖模型抽取得对不对,不依赖上下文有没有被挤掉,每次都是完整注入。缺点是占上下文,所以要控制在合理长度,只放真正必要的内容。
一份好用的档案通常包含这几块:我是谁(公司、业务、差异化)、我说什么(产品、价格口径、卖点)、我怎么说话(语气、称呼、禁用词)、我面对谁(客户画像、常见异议)、我不做什么(不能承诺的事、不能碰的话题)。
怎么判断该用哪一种
| 用哪一种 | 对应什么信息 | 什么时候会失效 |
|---|---|---|
| 会话内记忆草稿纸,说完就用 | 临时要求、当次格式 | 上下文有长度上限,几十轮之后最早的内容会被挤掉 |
| 长期记忆备忘录,显式写入 | 喜欢的风格、常用格式、最近在推的产品 | 没写就一定记不住;系统自动抽取会漏,也容易记错 |
| 结构化档案身份证,每次注入 | 公司名、业务范围、客户名单、合规红线 | 占上下文,要控制长度;业务变了不同步,会一直按旧信息答错 |
判断标准就一句:这条信息如果下次忘了,会不会导致它答错?会,就进档案;不会,就进长期记忆。
还有一个常被忽略的点:记忆要能改
记错了比不记更麻烦。客户改了产品线、换了主打款,如果档案没更新,Agent 会一直按旧信息答,而且答得很自信。
所以档案要有版本和更新机制:每次业务有变化,同步改档案;每季度过一遍,把过期的删掉。档案不是写完就放着的东西,它跟业务一起长。