「它答得不对」这句话背后至少有五种完全不同的病,用同一种办法去治,只会越治越乱。先把病认准,再动手。
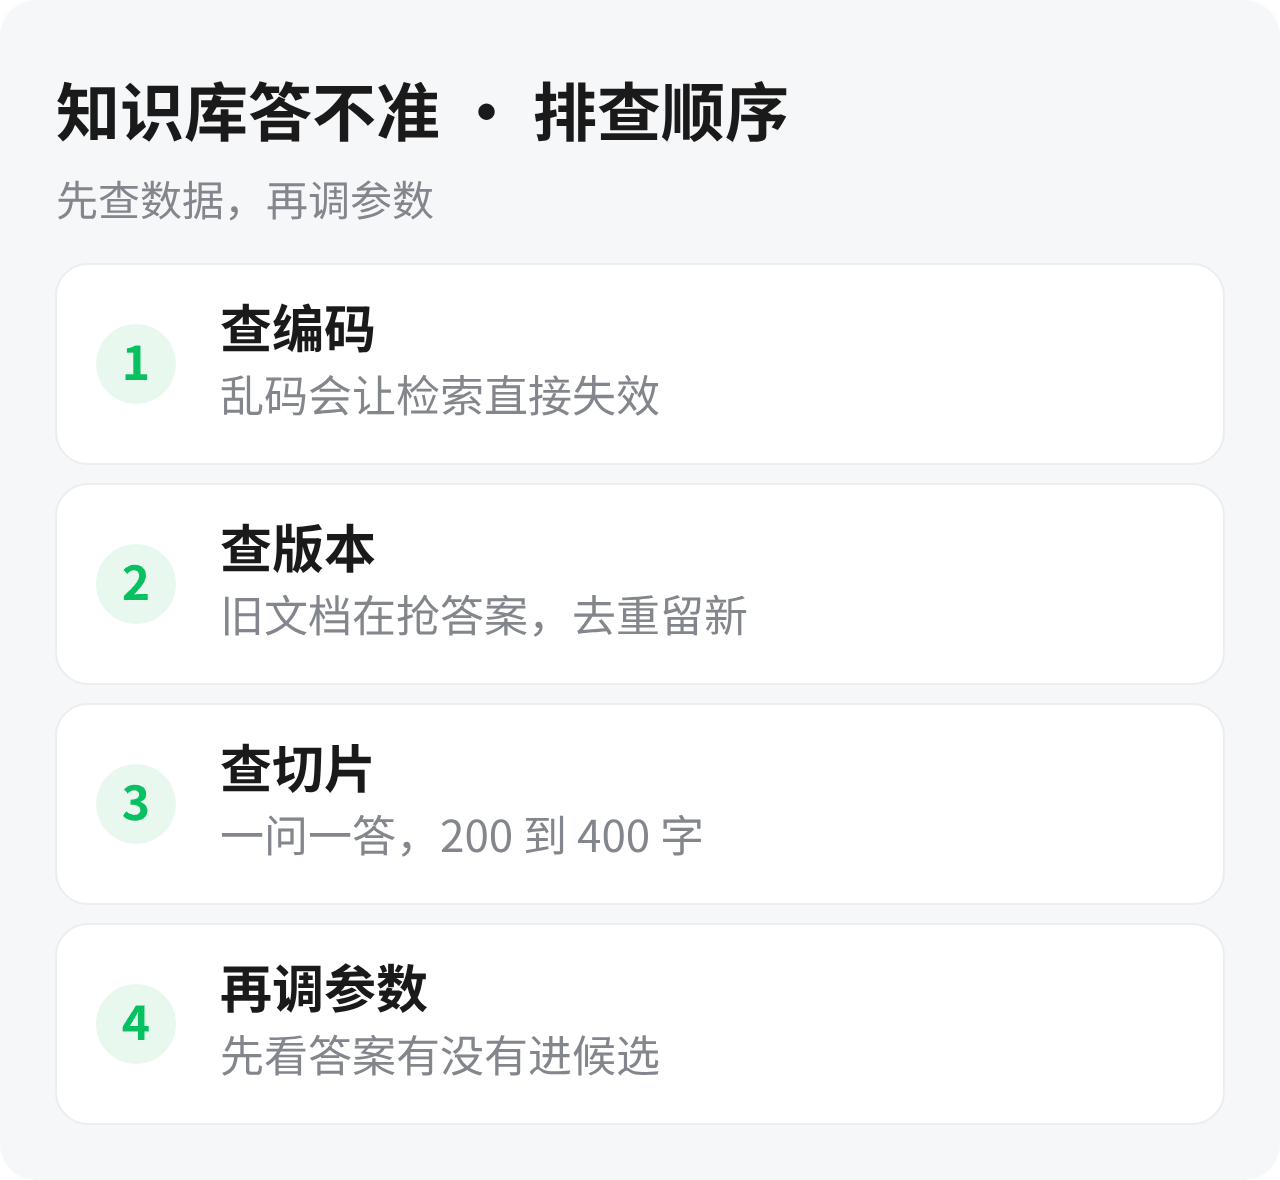
排查顺序很重要:先查编码,再查版本,然后查切片,最后才调参数和兜底。因为前三样是「数据本身坏了」,后两样才是「检索没调好」。数据坏着去调参数,怎么调都不对。
第一步:查编码,乱码会让检索直接失效
这一条排在第一位,因为它最容易被忽略,也最致命。中文文档如果编码不统一——比如一部分是 UTF-8、一部分是 GBK,或者导入时被二次转码——存进库里就是一堆乱码。乱码之后,向量化和关键词匹配全部失效,表现出来就是「答得完全不相关」。
怎么查:直接从数据库里把几条文档内容取出来,肉眼看一眼有没有「锟斤拷」「�」这类字符,或者一长串问号。有就是编码问题,别往下查了,先修这个。修的办法是把源文件统一转成 UTF-8 再重新导入,导入前先做一遍全量校验,别只抽查。
我们踩过这个坑:一批知识文档因为编码问题出现了重名和乱码条目,检索时经常命中的是废条目,看起来像「答不准」,实际是「命中了垃圾」。修完编码,同样的问题立刻正常。
第二步:查版本,旧文档在抢答案
知识库里同时存在同一份制度的新旧两版,是第二常见的病因。检索不看日期,只看相似度,旧版写得往往更详细,于是旧版赢。
怎么查:搜一个你确定改过的问题,看答的是新版还是旧版。如果是旧版,把所有历史版本清掉,只留最新一份,并且在文档标题里带上生效日期,比如「报销制度(2026 版)」。
顺便查重复:同一段内容被拆成多份导入,检索会同时命中好几条,模型把它们拼起来,答案就变成了缝合怪。去重是调优里性价比最高的一步。
第三步:查切片,一条切片只讲一件事
切片是知识库效果的分水岭。切太碎,一句话一段,检索时拿不到上下文,答出来像挤牙膏;切太大,一整篇塞进去,检索命中了但答案藏在中间,模型容易看漏。
我们的标准是一条切片对应一问一答,200 到 400 字。具体做法:把制度、流程、话术按「一个问题 + 一段完整回答」重写,而不是把原文按字数硬切。原文里的「如上所述」「见第三条」这类回指必须改掉,否则切片单独拎出来读不通,检索到了也用不了。
一个自检方法:把任意一条切片单独拿出来读,如果读完能独立看懂、不需要看别的段落,这条切片就合格。
第四步:调召回,先看答案有没有进候选
前三条都没问题,再来看检索参数。这里有个判断技巧:把模型先关掉,只看检索结果。拿一个问题去搜,看排在前 5 条的切片里有没有正确答案。
- 如果正确答案压根没进前 5 条——是召回问题。把 Top-K 从 3 调到 5 或 8,或者给文档补上用户真实会说的词(很多制度文档写「差旅费用核销」,用户问「出差报销怎么弄」,字面完全不搭)。
- 如果正确答案进了前 5 条但没被用上——是拼装问题。把切片数量减少、把相关度阈值调高,别让无关内容挤进上下文。
第五步:加兜底,不会就说不会
乱答最伤信任。一个「我不知道,我帮你转人工」的回答,比一个自信的错误答案好一百倍。
做法很简单:给模型一句硬约束——只能基于检索到的内容回答,检索内容里没有的,直接说不知道并给出转人工入口。同时在回答下面加一个「这个回答有用吗」的反馈按钮,点了没用的自动进待处理队列,每周清一次。
第六步:把没答好的问题变成下一批知识
知识库不是一次建完的,是养出来的。每周花半小时,把这周所有「答不上」「答偏」的问题导出来,按出现次数排序,前十条补进知识库。坚持一个月,解决率通常能从 50% 多提到 80% 以上。